确定模型与创作目标
角色、风格与产品需要不同的素材侧重点。Krea 2 用于当前云端训练;MOSS、Anima 通过各自兼容的 LoRA 生图。
 LoRA AI
你的角色,你的风格,你的下一次创作。
为角色、风格和产品准备数据集,使用 Krea 2、FLUX、Qwen Image 和 Z-Image 训练自定义 LoRA,探索 Wan 2.2 和 LTX 视频训练,并通过 MOSS、Anima 和兼容 LoRA 生成 AI 图片。
简明说明: 配置服务并准备足够积分及兼容数据集后,可训练已支持的图片和视频 LoRA。每种 LoRA 必须使用对应生成器;目录展示不代表模型互相兼容。
以下图片和视频均由 LoRA AI Image 与 LoRA AI Video 生成。点一个即可使用它的提示词。
这些原创图片由 AI 生成,仅作为概念参考;不是 LoRA AI 的训练产物、前后对比或模型性能证明。
Krea 2 提供已接通的云端训练与配套出图流程。MOSS 和 Anima 提供独立生图入口;视频模型与草稿工具保持可探索。提交训练或生图需要登录并有足够积分。
每个模型需要匹配的 LoRA,权重不能直接跨模型复用。分辨率与所需积分会在生成页展示。
以下费用和限制读取自应用配置。已接入表示代码具备相关功能,不代表已核实供应商实时状态或完成真实训练验证。
| 模型 | 接入状态 | 云端输入限制 | 积分与参数 | 输出与兼容性 |
|---|---|---|---|---|
| Krea 2 | 已接入,需配置服务 | 1–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 100 积分;生成每张 10 积分;固定训练步数 100。 | 成功后获得 LoRA 权重,使用配对的 Krea 2 生成模型;不代表与其他基础模型兼容。 |
| FLUX.1 Dev | 已接入,需配置服务 | 4–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 167 积分;生成每张 10 积分;固定训练步数 500。 | 成功后获得 LoRA 权重,使用配对的 FLUX.1 Dev 生成模型;不代表与其他基础模型兼容。 |
| FLUX.2 Dev | 已接入,需配置服务 | 10–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 2134 积分;生成每张 14 积分;固定训练步数 1000。 | 成功后获得 LoRA 权重,使用配对的 FLUX.2 Dev 生成模型;不代表与其他基础模型兼容。 |
| Qwen Image 2512 | 已接入,需配置服务 | 4–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 167 积分;生成每张 10 积分;固定训练步数 500。 | 成功后获得 LoRA 权重,使用配对的 Qwen Image 2512 生成模型;不代表与其他基础模型兼容。 |
| Z-Image Turbo | 已接入,需配置服务 | 4–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 209 积分;生成每张 10 积分;固定训练步数 500。 | 成功后获得 LoRA 权重,使用配对的 Z-Image Turbo 生成模型;不代表与其他基础模型兼容。 |
| Wan 2.2 | 已接入,需配置服务 | 3–10 个 MP4 片段及触发词。单个最多 8 MiB,总计最多 24 MiB。 | 训练:每次 1667 积分;生成:每 5 秒视频 67 积分;固定训练步数:100。 | 成功后获得 LoRA 权重,使用配对的 Wan 2.2 生成模型;不代表与其他基础模型兼容。 |
| LTX-2 19B | 已接入,需配置服务 | 3–10 个 MP4 片段及触发词。单个最多 8 MiB,总计最多 24 MiB。 | 训练:每次 584 积分;生成:每 5 秒视频 34 积分;固定训练步数:500。 | 成功后获得 LoRA 权重,使用配对的 LTX-2 19B 生成模型;不代表与其他基础模型兼容。 |
云端任务需要登录和足够积分。Krea 2 需要配置 Fal;WaveSpeed 图片及视频训练需要配置 WaveSpeed 和 R2 存储。
提交云端训练会将所选素材和标注发送给服务商。图片和视频的数据集限制不同,请在提交前确认账号可用。
专注训练准备
围绕一个角色、一种视觉风格或一款产品组织训练图片,让数据集、描述、模型与测试提示词相互配合。先检查素材,再提交 Krea 2 训练,完成后到生成页测试不同构图和场景。
角色、风格与产品需要不同的素材侧重点。Krea 2 用于当前云端训练;MOSS、Anima 通过各自兼容的 LoRA 生图。
在工作台查看图片尺寸、筛选重复素材,保留对概念有帮助的视角、光线与背景变化。提交云端训练前检查上传限制。
描述服装、姿态、背景等变化,保留角色或产品需要学习的核心特征。训练前核对触发词,减少无关信息干扰。
在“我的 LoRA”查看任务结果,完成后使用权重出图。记录提示词与参数,对比新场景里的概念表现,并保留数据集配置草稿。
值得模型学习的创意
从三个方向定义训练概念。每张参考图都链接到对应工作流,包含数据集建议与评估提示词。
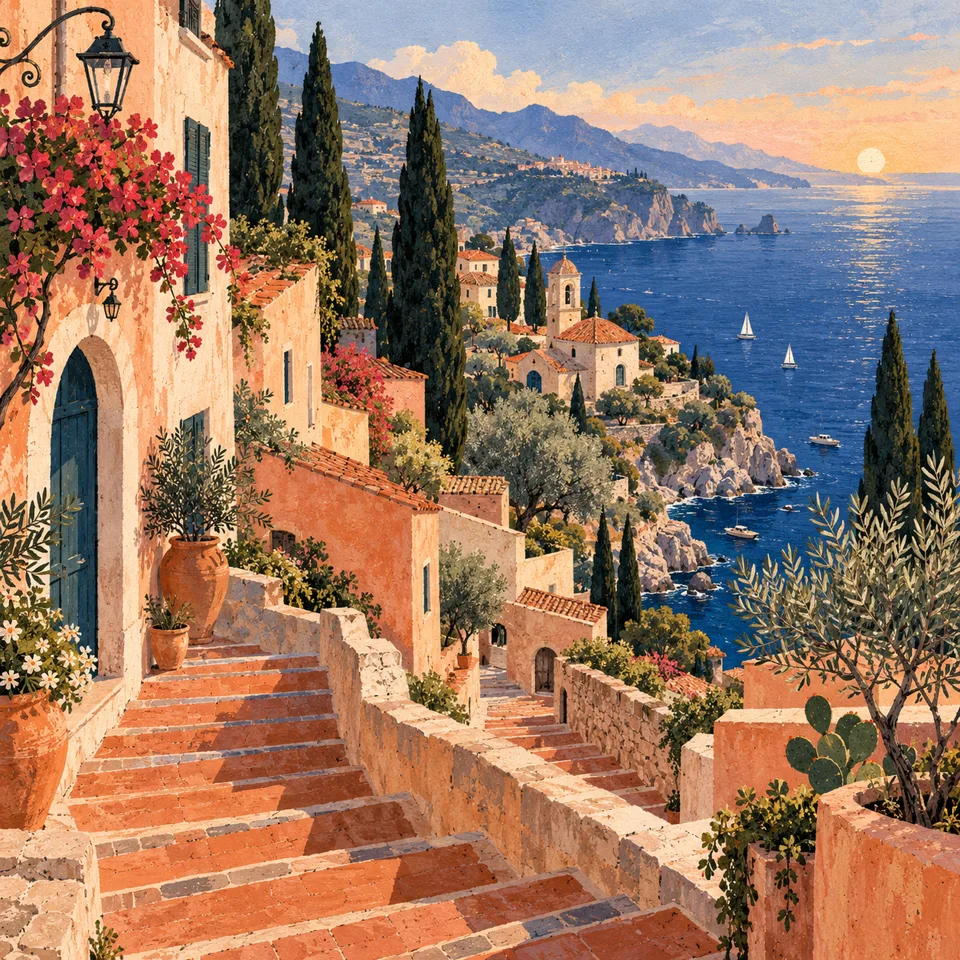
用海岸插画作为视觉语言参考。风格数据集应变换主体,同时保持材质、色彩与笔触的一致性。
图片描述示例A coastal village in ohwx_style, gouache texture, warm flat colors and fine ink contours.
查看风格 LoRA 训练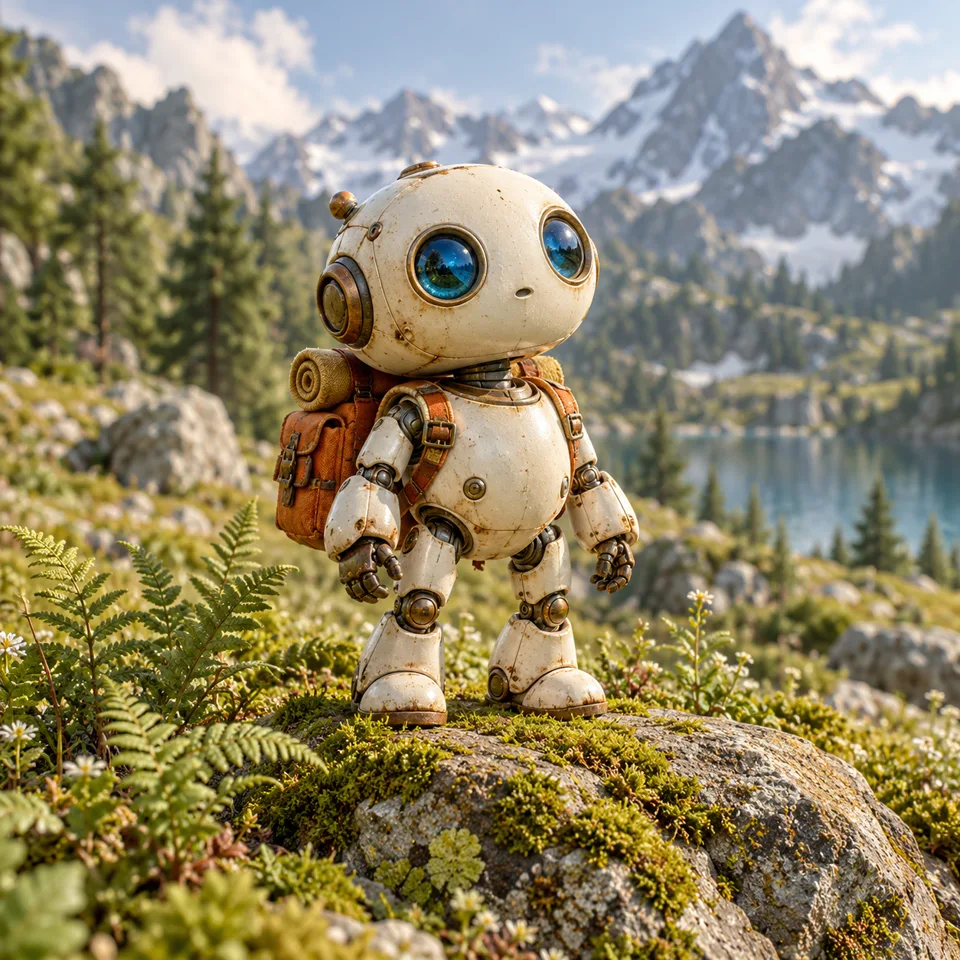
原创陶瓷探险机器人为数据集提供明确的角色身份。变化角度、姿态与环境,避免重复同一种构图。
图片描述示例ohwx_robot, a ceramic explorer with blue glass eyes, standing beside an alpine lake in daylight.
查看角色 LoRA 训练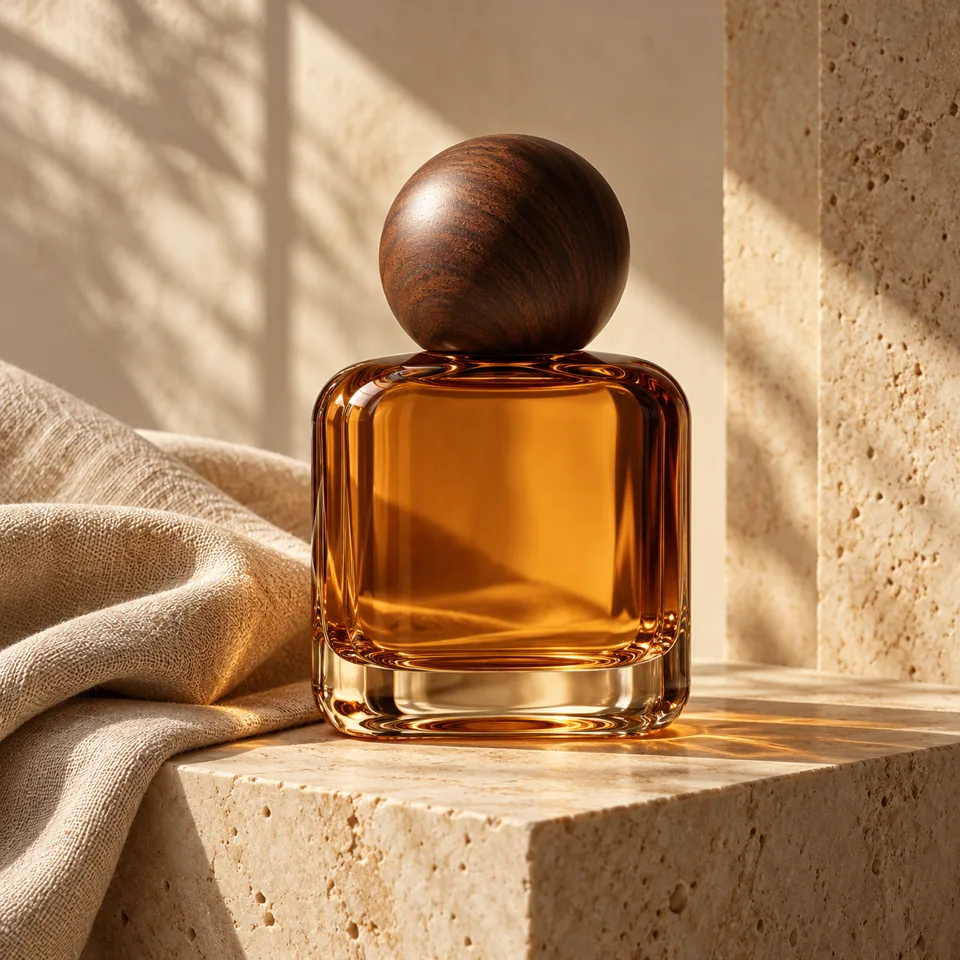
无品牌琥珀色瓶子便于观察形状与材质。补充玻璃瓶身与瓶盖的不同角度,避免只学习同一个背景。
图片描述示例ohwx_bottle, an amber glass bottle with a round walnut cap, on a travertine surface in window light.
查看产品 LoRA 训练这些原创图片由 AI 生成,仅作为概念参考;不是 LoRA AI 的训练产物、前后对比或模型性能证明。
从目标到评估
按照所选模型的要求准备图片或视频数据集,检查触发词和标注后提交训练。训练完成后,在对应的生成器中使用权重。
数据集与兼容性
先决定模型,再组织素材。Krea 2 训练出的权重用于兼容的 Krea 2 生图流程;MOSS 与 Anima 使用各自适配的权重。相似的模型名称不能证明 LoRA 可以互换。
阅读数据集准备指南提示词笔记
保存这些思路,用于之后评估兼容的训练适配器。它们是提示词示例,不代表生成结果或效果保证。
A hillside library in ohwx_style, warm flat colors, textured paper and delicate ink contours.
A vintage desk lamp in ohwx_style, simple composition, warm ochre and indigo palette.
A quiet forest path after rain in ohwx_style, layered shapes, visible gouache texture.
A small sailboat in ohwx_style, bold simplified forms, soft paper grain, no lettering.
An original fictional gardener in ohwx_style, full-body pose, simple pale background.
A night market in ohwx_style, restrained blue and amber palette, hand-painted details.
相关笔记
了解素材选择、图片描述、训练设置,以及如何判断模型真正学到了什么。
FAQ
针对所选模型的实用说明,并明确当前开放情况。
当前已接通 Krea 2 图片 LoRA 训练,适合围绕角色、视觉风格或产品概念准备素材。进入训练工作台,检查图片、编辑描述并核对触发词;登录且积分足够后提交。任务状态和成功后的权重可在“我的 LoRA”查看。训练目录中的其他模型与视频训练暂未开放云端提交。
Krea 2 训练成功后,可以从“我的 LoRA”进入配套生成页,输入新提示词测试图片。MOSS 和 Anima 也可独立生图,但需要匹配各自模型的 LoRA,不能直接复用 Krea 2 权重。提交前生成页会显示所需积分;本地数据准备与配置草稿导出免费。
Krea 2、FLUX.1、FLUX.2 Dev、Qwen Image、Z-Image、Wan 2.2 I2V 和 LTX-2 19B 已接入训练及配套生成。付费任务需要配置服务、登录并准备足够积分。其他目录模型仍为预览。
仅整理本地草稿时,图片在当前浏览器标签页内处理,导出的 JSON 不含原图;刷新或离开会清空本地图片。提交云端训练时,选中的数据集与描述会发送给供应商;WaveSpeed 训练还会使用已配置的 R2 存储保存数据集和归档产物,存储隐私取决于存储桶访问配置。生图会将提示词和所选 LoRA 引用发送给对应服务。请仅提交有权使用的素材。
不能直接互换。需要匹配模型架构、基础版本和加载流程。Krea 2、MOSS 与 Anima 使用各自兼容的权重;名称相似不代表兼容。视频模型的工作流程还可能需要多个适配器文件。
继续探索
选择训练流程前,先比较相关模型家族。适配器格式与基础模型版本必须保持兼容。
选择匹配的模型,整理图片与描述,再提交已开放的训练或生图流程。你也可以先免费导出数据集配置草稿。